登录社区云,与社区用户共同成长
邀请您加入社区
循环体中可以更改不同的job和job完成后的处理,文件也可以采用不同的命名方式来写,以实现个性化需求。如果一个job结束之后是另外的job,则可以实现一个完整的工作流work flow,真正的解放双手,提高生产力,一键式操作。
这里之所以这么复杂,是因为还上传了文件格式,如果不需要上传文件,直接包装成requestBody。另一种(这两种都没试,我用的requestbody)参数:数组类型 Integer[] ids。
用心整理,一篇不缺,持续更新,免费分享,仅供学习。
fastapi运行有两种方法:使用命令行的方式运行:uvicorn py文件名:app --reload使用python运行:python py文件名方法一:命令行启动fastapi在一个文件main.py中写入:from fastapi import FastAPIapp = FastAPI()@app.get("/")async def hello_world():return {"hello
初期的互联网,写爬虫是门技术活,往大的方向说,爬虫技术是搜索引擎的组成部分。随着互联网技术的发展,写爬虫的门槛一降再降,一些编程语言甚至直接提供爬虫框架,例如python的Scrapy框架,它们让写爬虫走入“寻常百姓家”。我们已经发现,写爬虫是一件炫酷的事情,但即使是这样,学习爬虫仍然有一定的技术门槛。当前的主流爬虫手段是用Python编程,Python的强大毋庸置疑,但初学者学习Python还是
A算法是一种启发式路径搜索算法,通过评估函数f(n)=g(n)+h(n)平衡路径成本与启发式估计,在路径规划中高效寻找最优解。文章详细介绍了算法原理、步骤及C#实现代码,重点分析了不同启发式函数(和、距离、差值)对搜索效率的影响。实验表明,在复杂障碍物地图中,采用差值评估(f=h-g)比传统和评估(f=g+h)具有更好的方向引导性,能显著减少不必要的节点探索。文章建议根据地图特性灵活选择评估函数,
错误配置,虽然在这配置的是对的,但是就是解析不成功。正确配置,(以下已经是配置正确了的)编辑配置后点快了,应该是在这配置的。在这配置正确的解释器。
pythonGO入门手把手
我从24年11月份开始学习网络爬虫应用开发,经过2个来月的努力,于1月下旬完成了开发一款网络爬虫软件的学习目标。这里对本次学习及应用开发进行一下回顾总结。前几天我已经发了一篇日志(网络爬虫学习:应用selenium从搜*狐搜索爬取新闻结果的数据)记录了应用中使用的爬虫技术。这篇日志记录另外一个问题的解决。
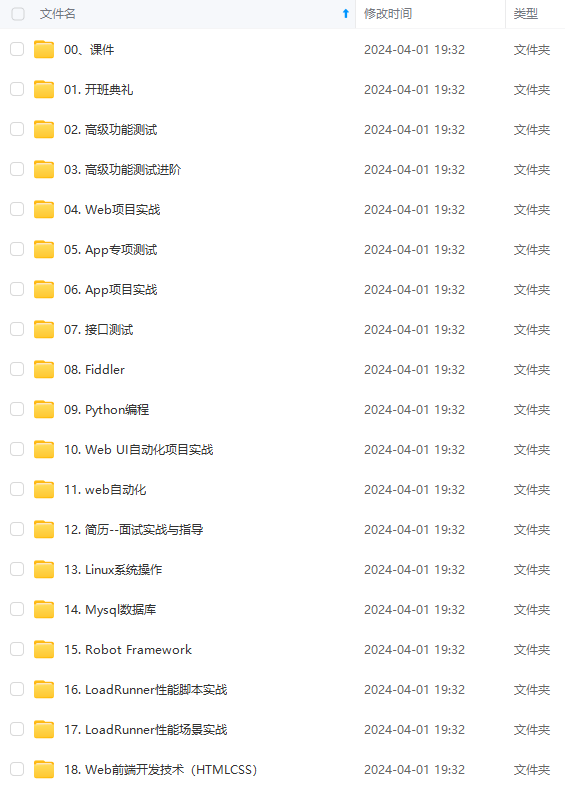
爬虫从0到精通学习路线
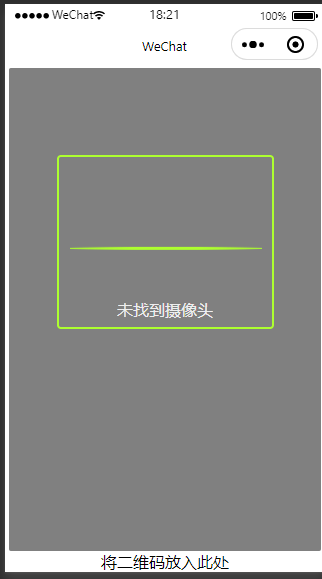
微信小程序扫码使用wx.scanCode(Object,Object)调起客户端扫码界面进行扫码这个是小程序提供的相关扫码api,可以直接调用该api实现扫码相关参数使用例子:直接调用api,然后参数的话可以参考微信公众号平台网站//scan.js/*** 页面的初始数据*/data: {scanCode:'扫码',},scanCodeEvent: function(){var that = th
链接:https://pan.baidu.com/s/1sa7LynWGH47flpO2mArVWA?链接:https://pan.baidu.com/s/19BCTfW79tp4FSTgIPn08Wg?链接:https://pan.baidu.com/s/1j_KaRsqY4dlcATISCGudqQ?2016年——2021年官方历年模拟题。FRM二级近两年notes。
Crawley 是一种 Python 爬取和采集框架,意在简化开发人员从 Web 网页抽取数据到数据库等结构化存储中。
这是 TARA 的起点,“范围定义不清晰,后续全白费”。需要避免对整个车辆进行一次宏观的 TARA,而应采用“放大镜”方法,聚焦于特定功能或系统。项目边界 (Item Boundary): 明确哪些组件、接口和外部系统在本次分析范围内。项目功能 (Item Functions): 描述该项目(功能)的预期行为,特别是输入和输出关系。运行环境 (Operational Environment): 定
同步IO异步IOread系统,分为两个阶段:等待数据就绪(步骤一/阶段一),把就绪的数据从内核空间拷贝到用户的进程空间(步骤二/阶段二) 先说结论:各种IO模型其实是根据它在上述两个阶段的不同表现(用户进程或者线程是否阻塞)来区分的!!!在第一个阶段用户进程是否阻塞用来区分阻塞/非阻塞,在第二个阶段用户是否阻塞用来区分同步/异步!!!
用法: ContextInfo.run_time(funcName,period,startTime) 定时触发指定的 funcName函数, funcName函数由用户定义, 入参为ContextInfo对象。有三个参数:funcName:回调函数名period:重复调用的时间间隔,'5nSecond'表示每5秒运行1次回调函数,'5nDay'表示每5天运行一次回调函数,'500nMilliSe
本文通过Python Tushare库获取工业富联和潍柴重机股票数据,进行相关性分析与可视化。主要步骤包括:数据获取与预处理、合并数据表、计算收益率和相关系数。结果显示两只股票日收益率的相关系数为0.4,呈现中等正相关。通过绘制价格走势对比图、收益率散点图、60日滚动相关系数图等,直观展示了两只股票的联动关系。此外,还分析了成交量与价格的关系,为投资组合构建提供数据支持。该分析过程展示了Pytho
作者:小宾链接:https://www.nowcoder.com/discuss/720831?source_id=discuss_experience_nctrack&channel=-1来源:牛客网面试官感觉应该是主管级,思维广度发散很快,逻辑清晰,能很快抓住你回答的错误和重点涉及Java、mybatis、redis、zk上来问了我学校做的外包项目,没问实习项目(实习项目主流语言是go
摘要:本文基于1981-2010年基准期数据,采用百分位法定义极端气候事件,创新提出"持续事件"概念来评估极端气候的累积效应。通过连续三天出现极端天气即计为一次持续事件,重复计算重叠天数以反映强度,构建了2011-2022年中国地级市尺度的极端气候风险指数数据集。该数据包含极端高温、低温、干旱和降水四个维度的持续次数及其综合风险指数,采用Excel格式呈现,可为气候变化影响研究
网络安全投资需平衡安全与发展的关系。微软网络安全总监张美波指出,企业面临自动化攻击和APT攻击双重威胁,需在满足合规要求的同时优化安全投入。网络安全经济学强调投入产出分析,建议企业参考;网络安全ROI象限图评估技术投入效益。关键策略包括:建立全面安全体系、加强员工培训、合理风险管理、与专业机构合作等。企业应找到安全与发展的平衡点,避免过度投入阻碍业务创新,通过科学的成本效益分析实现最优防护。
爬虫教程( 1 )--- 爬虫教程、路线、spidertools、大佬博文
无头模式下的user-agent。
手把手教你用AI写一个完整的策略
本文系统总结了堆(优先级队列)的基础知识与应用场景。首先比较堆与栈的区别:栈维护元素顺序,堆维护元素频率。详细介绍了PriorityQueue的创建方式(默认小顶堆、指定容量、自定义比较器)及常用API(add/offer、remove/poll、peek/size等)。通过三个经典案例详解堆的应用:1)快速选择算法求第K大元素;2)HashMap统计频率+最小堆维护TopK高频元素;3)双堆法(
在World Quant平台中,本质上是一个数学公式,它是**operator(操作)Data(数据)**的组合。
程序员写代码并不是从0开始的,我们也是需要借助多个模板拼接,使得代码能够实现我们的想法,而且也并非默写出来,毕竟学习编程是开卷学习,开卷使用,加油,希望你我一同走进爬虫的世界~~
Sigma delta ADC学习记录
摘要:因子投资从华尔街专业工具发展为大众可及的量化方法,其核心是将投资逻辑转化为可验证的数学因子。开源平台FactorHub通过整合数据获取、因子计算、回测分析等全流程,大幅降低了量化投资门槛。该平台采用模块化设计和并行计算技术,提供200多个预置因子和可视化分析工具,支持个人投资者和机构快速验证投资策略。FactorHub的兴起反映了量化投资民主化趋势,通过开源生态推动投资决策的科学化,使专业级
爬虫是获取数据的一种方式,网络上很多请求都是由爬虫发起的。①想要做舆论分析,分析当前热点话题,可以爬取腾讯新闻,微博,今日头条等主流站点数据,然后进行分析;②想要做电影推荐或影评分析,可以爬取豆瓣,猫眼等数据进行分析;③想要做电商销售分析,可以爬取京东,淘宝商家数据进行分析;当我们使用高并发或者分布式爬虫对这些站点进行抓取时,①短时间内大量请求占用站点资源:网络带宽,服务器负载;②如果我们获取数据
类是用来描述具有相同属性和方法的对象集合。人可以通过不同的肤色划分为不同的种族,食物也有不同的种类,商品也是形形色色。但划分为同一类的物体,肯定具有相似的特征和行为方式。对于同一款自行车而言,它们的组成结构都是一样的,如车架、车轮和脚踏板等。
目前 各类旋转/可逆矩阵对量化参数进行预变换(QuaRot、SpinQuant、QServe、以及FlatQuant。大模型后量化算法迭代迅速,早期进行线性层缩放(AWQ/SmoothQuant),设计预量化变换 量化、 及低精度矩阵相乘的融合算子也尤为重要。
我们假设数据总有用完的一天,有限数据下,只通过RL训练便能够“涌现”在深度推理回答的长度和反思的能力,是更充分的数据挖掘,这是grpo的初衷。重要性采样:重要性采样是一种通过调整样本权重,用旧分布(旧策略)的样本来估计新分布(新策略)期望值的方法。GRPO的创新点:直接使用组内样本的奖励计算基线,无需Critic模型,降低了计算成本。Critic 模型:是强化学习中价值函数的一种表示,主要用于评估
Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。工具都帮大家整理好了,安装就可直接上手!当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。观看全面零基础学习视频,看视频学习是最快捷也
学习Python爬虫怎么赚钱?(文末免费赠Python资料)
再说一下开通量化交易软件的条件,仅需要在券商开户,资金达到合规门槛既可申请免费使用。佣金费用为万0.854 ETF免5,非常厚道,有更多交易的客制化需求或者想深入了解系统可联系我:XD1996CD。
而backtrader中分钟线合成时机是物理时间整分钟触发的(可以设置合成时机推迟比如一秒,以考虑网络延时),每到整分钟,比如10点整,你的客户端开始聚合收集到的tick,为每个标的合成1分钟k线。多标的,多周期在实盘时处理时,由于存在不确定的网络延时,更加复杂。当然啦,backtrader也有局限性,那就是很多人看不懂,其实想量化交易,还是有很多其他选项的,例如交易接口、破解版等等,可以做高频,
在这个时代AI与我们每个人息息相关1956年在美国召开了第一场人工智能研讨会,由此人类开始了对人工智能道路探索。在这场会议上纽维尔和西蒙演示了一个名为"逻辑学家"的程序充分展示了机器能做类似推理的工作。在这个会议上人工智能获得了定义。1978年国内第一所人工智能与智能控制研究组在清华大学成立,并且同年招收了第1批硕士生。那时主要以智能机器人作为主要研究方向。1990年智能技术与系统国家重点实验室正
开发成功,qmt小市值策略,随策略配入大盘择时的资金配置使用,再加入动量策略,排序选择,涨幅最大的股票,进行购买。根据大盘的数据,选择资金仓位,然后同时设置动量策略,
筛选出沪深300指数2007-2009年的极大值点对应当天的数据。利用akshare数据源,采用定投策略,进行策略回测。按周定投vs按月定投。
本文只介绍常用的api,尽量以最简单的形式学会mongoTemplate基础api的使用。
LVGL学习笔记摘要:本文系统介绍了LVGL图形库的核心概念和应用方法。主要内容包括:1)LVGL基于部件(Widget)的设计思想,所有控件继承自lv_obj_t基类;2)详细对比了LVGL8.3和v9版本在控件、样式系统、布局系统等方面的差异;3)深入解析了父子对象关系、事件传递、样式继承等关键机制;4)通过创建屏幕、按钮、组对象等实例演示开发流程;5)提出前后端解耦的嵌入式架构设计方案,强调
本文分享了作者从传统EMA均线转向考夫曼自适应移动平均(KAMA)的学习心得。KAMA通过动态调整平滑系数,有效解决了传统均线滞后性问题:在趋势行情中紧贴价格增强灵敏度,在震荡市过滤噪音提高稳定性。文章详解KAMA三大核心模块(自适应计算、多空可视化、信号决策),提供动态止损方案和代码示例。实战数据显示,KAMA策略年化收益达34.2%,最大回撤仅12.3%,显著优于传统双均线。文末建议参数优化方
随着国家政策支持和技术发展,Web安全行业迎来爆发式增长。文章指出,当前企业对信息安全人才需求旺盛,相关岗位薪资普遍在15k以上。白帽子黑客可通过企业专职工作或向SRC平台提交漏洞获取高额奖金,如腾讯TSRC、oppoSRC等平台提供额外奖励。文章详细介绍了漏洞挖掘流程,并汇总了阿里巴巴、百度、京东等主流企业的SRC平台链接,为有意从事Web安全的人员提供实用参考。
自从chatGPT出现后,对于文本处理的能力直接上升了一个维度。在这之前,我们爬取到网络上的文本内容之后,都需要写一个文本清理的程序,对文本进行清洗,而现在,有了chatGPT的加持,我们只需要几秒,就可以很方便对所有类型,所有格式的文本内容,完成清洗,去除那些html标签等。对于清洗后的文章,我们仍然可以做很多事情,比如,提取核心观点,文章改写等操作,使用chatGPT都可以很轻松的解决。
本文介绍了使用Python构建比特币量化交易系统的完整流程。首先概述了加密货币量化交易市场现状,包括日交易量达300亿美元、量化交易占比70%等关键数据。随后详细讲解了技术架构设计,涵盖数据获取、策略开发、回测引擎、风险管理和可视化等模块。文章重点演示了双均线交易策略的实现,包括数据采集(CCXT库)、策略开发(Backtrader框架)、参数优化和实盘交易对接(Binance API)等环节。同
如果没有请求头,使用代码发送的请求会被服务器检测出来是爬虫代码,从而导致返回的结果不是所需要的内容或者内容不全,这种解决方案就是发送请求时带上header参数,模拟浏览器,欺骗服务器,从而获取和浏览器一模一样的内容。获取的是原始的二进制数据(bytes类型的数据),需要通过decode()方法解码为字符串类型。例子:通过requests向百度首页发送请求,获取百度首页的数据。注意编码和解码的方式必
网络安全领域提供了多种合法利用漏洞赚钱的途径,主要包括:1)参与漏洞赏金计划,通过HackerOne等平台报告漏洞获取奖励;2)提供安全咨询服务,帮助企业评估和优化安全体系;3)开展安全培训和教育;4)撰写安全研究文章和博客;5)参加CTF竞赛赢取奖金;6)开发和销售安全工具。这些方法均强调在法律和道德框架内操作,既能获得经济收益,又能提升个人声誉和技能。此外,文章还提供了网络安全学习资料包,包含
HTTP协议是Hyper Text Transfer Protocol(超文本传输协议)的缩写,是用于万维网(WWW:World Wide Web )服务器与本地浏览器之间传输超文本的传送协议。HTTP是一个属于应用层的面向对象的协议,由于其简捷、快速的方式,适用于分布式超媒体信息系统。它于1990年提出,经过几年的使用与发展,得到不断地完善和扩展。HTTP协议工作于客户端-服务端架构为上。浏览器
uvicorn是一个基于asyncio开发的一个轻量级高效的web服务器框架uvicorn 设计的初衷是想要实现两个目标:使用uvloop和httptools 实现一个极速的asyncio服务器实现一个基于ASGI(异步服务器网关接口)的最小应用程序接口。目前支持http, websockets, Pub/Sub 广播,并且可以扩展到其他协议和消息类型。安装使用uvicorn 仅支持python