SMA — 移动平均及双均线模型
0. 引库
%matplotlib inline
import matplotlib.pyplot as plt
import seaborn
plt.style.use('seaborn')
import matplotlib as mpl
mpl.rcParams['font.family'] = 'serif'
import warnings; warnings.simplefilter('ignore')
import numpy as np
import pandas as pd
import tushare as ts
1. 前导知识备习
data = ts.get_k_data('600030', start = '2010-01-01', end='2017-06-30')
data.head()
| date | open | close | high | low | volume | code |
|---|
| 0 | 2010-01-04 | 17.016 | 16.639 | 17.176 | 16.612 | 1106207.58 | 600030 |
|---|
| 1 | 2010-01-05 | 16.777 | 17.452 | 17.601 | 16.383 | 2093915.41 | 600030 |
|---|
| 2 | 2010-01-06 | 17.548 | 17.250 | 17.628 | 17.229 | 1437889.30 | 600030 |
|---|
| 3 | 2010-01-07 | 17.239 | 16.830 | 17.484 | 16.697 | 1235592.34 | 600030 |
|---|
| 4 | 2010-01-08 | 16.718 | 17.154 | 17.208 | 16.644 | 1040929.92 | 600030 |
|---|
data.set_index('date', inplace = True)
data.head()
| open | close | high | low | volume | code |
|---|
| date | | | | | | |
|---|
| 2010-01-04 | 17.016 | 16.639 | 17.176 | 16.612 | 1106207.58 | 600030 |
|---|
| 2010-01-05 | 16.777 | 17.452 | 17.601 | 16.383 | 2093915.41 | 600030 |
|---|
| 2010-01-06 | 17.548 | 17.250 | 17.628 | 17.229 | 1437889.30 | 600030 |
|---|
| 2010-01-07 | 17.239 | 16.830 | 17.484 | 16.697 | 1235592.34 | 600030 |
|---|
| 2010-01-08 | 16.718 | 17.154 | 17.208 | 16.644 | 1040929.92 | 600030 |
|---|
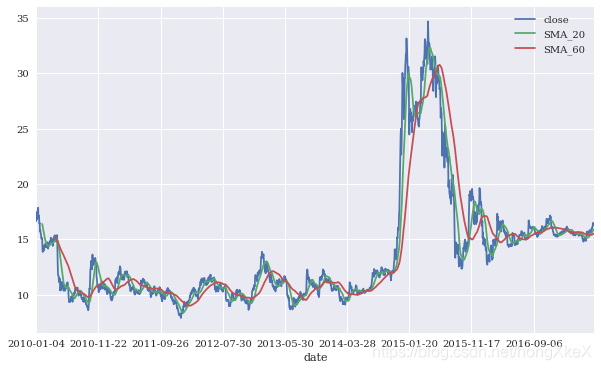
data['SMA_20'] = data['close'].rolling(20).mean()
data['SMA_60'] = data['close'].rolling(60).mean()
data.tail()
| open | close | high | low | volume | code | SMA_20 | SMA_60 |
|---|
| date | | | | | | | | |
|---|
| 2017-06-26 | 16.186 | 16.492 | 16.635 | 16.148 | 2113195.0 | 600030 | 15.79700 | 15.467750 |
|---|
| 2017-06-27 | 16.482 | 16.349 | 16.511 | 16.301 | 924024.0 | 600030 | 15.83140 | 15.482400 |
|---|
| 2017-06-28 | 16.320 | 16.330 | 16.502 | 16.253 | 871050.0 | 600030 | 15.86245 | 15.497533 |
|---|
| 2017-06-29 | 16.320 | 16.330 | 16.425 | 16.224 | 668341.0 | 600030 | 15.89685 | 15.513783 |
|---|
| 2017-06-30 | 16.263 | 16.263 | 16.349 | 16.072 | 751091.0 | 600030 | 15.92745 | 15.528283 |
|---|
data[['close','SMA_20','SMA_60']].plot(figsize = (10,6))
data['returns'] = np.log(data['close'] / data['close'].shift(1))
data['returns_dis'] = data['close']/data['close'].shift(1) - 1
data['return_dis2'] = data['close'].pct_change()
data.head()
| open | close | high | low | volume | code | SMA_20 | SMA_60 | returns | returns_dis | return_dis2 |
|---|
| date | | | | | | | | | | | |
|---|
| 2010-01-04 | 17.016 | 16.639 | 17.176 | 16.612 | 1106207.58 | 600030 | NaN | NaN | NaN | NaN | NaN |
|---|
| 2010-01-05 | 16.777 | 17.452 | 17.601 | 16.383 | 2093915.41 | 600030 | NaN | NaN | 0.047705 | 0.048861 | 0.048861 |
|---|
| 2010-01-06 | 17.548 | 17.250 | 17.628 | 17.229 | 1437889.30 | 600030 | NaN | NaN | -0.011642 | -0.011575 | -0.011575 |
|---|
| 2010-01-07 | 17.239 | 16.830 | 17.484 | 16.697 | 1235592.34 | 600030 | NaN | NaN | -0.024649 | -0.024348 | -0.024348 |
|---|
| 2010-01-08 | 16.718 | 17.154 | 17.208 | 16.644 | 1040929.92 | 600030 | NaN | NaN | 0.019068 | 0.019251 | 0.019251 |
|---|
data['position'] = np.where(data['SMA_20'] > data['SMA_60'], 1, -1)
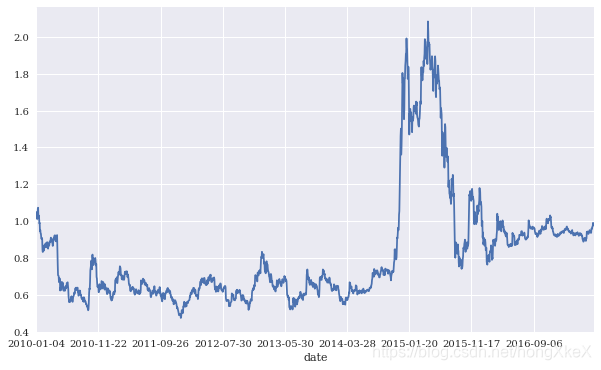
data['returns'].cumsum().apply(np.exp).plot(figsize=(10, 6));
SMA策略
1. 数据准备 & 回测准备
import numpy as np
import pandas as pd
import tushare as ts
data = ts.get_k_data('hs300', start = '2010-01-01', end='2017-06-30')
data = pd.DataFrame(data)
data.head()
| date | open | close | high | low | volume | code |
|---|
| 0 | 2010-01-04 | 3592.468 | 3535.229 | 3597.75 | 3535.23 | 66101080.0 | hs300 |
|---|
| 1 | 2010-01-05 | 3545.186 | 3564.038 | 3577.53 | 3497.66 | 85809641.0 | hs300 |
|---|
| 2 | 2010-01-06 | 3558.700 | 3541.727 | 3588.83 | 3541.17 | 78473125.0 | hs300 |
|---|
| 3 | 2010-01-07 | 3543.160 | 3471.456 | 3558.56 | 3452.77 | 80350037.0 | hs300 |
|---|
| 4 | 2010-01-08 | 3456.908 | 3480.130 | 3482.08 | 3426.70 | 60790253.0 | hs300 |
|---|
data.rename(columns={'close': 'price'}, inplace=True)
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1819 entries, 0 to 1818
Data columns (total 7 columns):
date      1819 non-null object
open      1819 non-null float64
price     1819 non-null float64
high      1819 non-null float64
low       1819 non-null float64
volume    1819 non-null float64
code      1819 non-null object
dtypes: float64(5), object(2)
memory usage: 113.7+ KB
data.head()
| date | open | price | high | low | volume | code |
|---|
| 0 | 2010-01-04 | 3592.468 | 3535.229 | 3597.75 | 3535.23 | 66101080.0 | hs300 |
|---|
| 1 | 2010-01-05 | 3545.186 | 3564.038 | 3577.53 | 3497.66 | 85809641.0 | hs300 |
|---|
| 2 | 2010-01-06 | 3558.700 | 3541.727 | 3588.83 | 3541.17 | 78473125.0 | hs300 |
|---|
| 3 | 2010-01-07 | 3543.160 | 3471.456 | 3558.56 | 3452.77 | 80350037.0 | hs300 |
|---|
| 4 | 2010-01-08 | 3456.908 | 3480.130 | 3482.08 | 3426.70 | 60790253.0 | hs300 |
|---|
data.set_index('date', inplace = True)
data.head()
| open | price | high | low | volume | code |
|---|
| date | | | | | | |
|---|
| 2010-01-04 | 3592.468 | 3535.229 | 3597.75 | 3535.23 | 66101080.0 | hs300 |
|---|
| 2010-01-05 | 3545.186 | 3564.038 | 3577.53 | 3497.66 | 85809641.0 | hs300 |
|---|
| 2010-01-06 | 3558.700 | 3541.727 | 3588.83 | 3541.17 | 78473125.0 | hs300 |
|---|
| 2010-01-07 | 3543.160 | 3471.456 | 3558.56 | 3452.77 | 80350037.0 | hs300 |
|---|
| 2010-01-08 | 3456.908 | 3480.130 | 3482.08 | 3426.70 | 60790253.0 | hs300 |
|---|
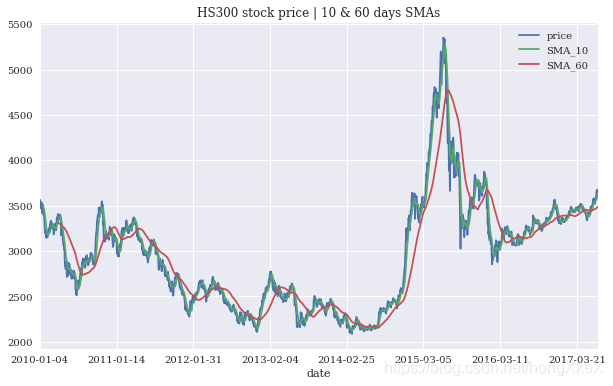
data['SMA_10'] = data['price'].rolling(10).mean()
data['SMA_60'] = data['price'].rolling(60).mean()
data.tail()
| open | price | high | low | volume | code | SMA_10 | SMA_60 |
|---|
| date | | | | | | | | |
|---|
| 2017-06-26 | 3627.02 | 3668.09 | 3671.94 | 3627.02 | 134637995.0 | hs300 | 3573.455 | 3475.314500 |
|---|
| 2017-06-27 | 3665.58 | 3674.72 | 3676.53 | 3648.76 | 97558702.0 | hs300 | 3582.700 | 3478.729667 |
|---|
| 2017-06-28 | 3664.16 | 3646.17 | 3672.19 | 3644.03 | 97920858.0 | hs300 | 3593.787 | 3481.746000 |
|---|
| 2017-06-29 | 3649.25 | 3668.83 | 3669.13 | 3644.73 | 85589498.0 | hs300 | 3607.791 | 3485.613833 |
|---|
| 2017-06-30 | 3654.73 | 3666.80 | 3669.76 | 3646.23 | 81510028.0 | hs300 | 3622.595 | 3489.126333 |
|---|
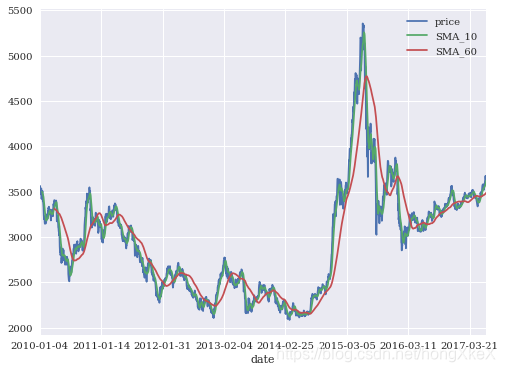
data[['price','SMA_10','SMA_60']].plot(title='HS300 stock price | 10 & 60 days SMAs', figsize=(10, 6));
2. 策略开发思路
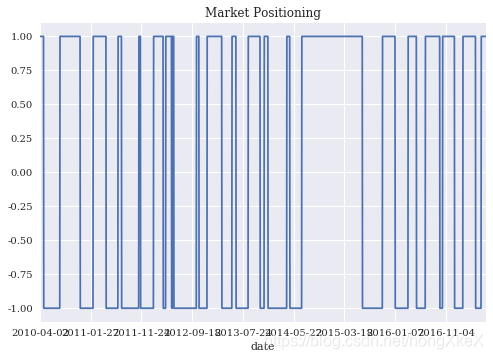
data['position'] = np.where(data['SMA_10'] > data['SMA_60'], 1, -1)
data.head()
| open | price | high | low | volume | code | SMA_10 | SMA_60 | position |
|---|
| date | | | | | | | | | |
|---|
| 2010-01-04 | 3592.468 | 3535.229 | 3597.75 | 3535.23 | 66101080.0 | hs300 | NaN | NaN | -1 |
|---|
| 2010-01-05 | 3545.186 | 3564.038 | 3577.53 | 3497.66 | 85809641.0 | hs300 | NaN | NaN | -1 |
|---|
| 2010-01-06 | 3558.700 | 3541.727 | 3588.83 | 3541.17 | 78473125.0 | hs300 | NaN | NaN | -1 |
|---|
| 2010-01-07 | 3543.160 | 3471.456 | 3558.56 | 3452.77 | 80350037.0 | hs300 | NaN | NaN | -1 |
|---|
| 2010-01-08 | 3456.908 | 3480.130 | 3482.08 | 3426.70 | 60790253.0 | hs300 | NaN | NaN | -1 |
|---|
data.dropna(inplace=True)
data['position'].plot(ylim=[-1.1, 1.1], title='Market Positioning');
3. 计算策略年化收益并可视化
data['returns'] = np.log(data['price'] / data['price'].shift(1))
data.head()
| open | price | high | low | volume | code | SMA_10 | SMA_60 | position | returns |
|---|
| date | | | | | | | | | | |
|---|
| 2010-04-02 | 3400.139 | 3407.346 | 3412.20 | 3391.81 | 69073452.0 | hs300 | 3322.9136 | 3313.538117 | 1 | NaN |
|---|
| 2010-04-06 | 3422.849 | 3405.145 | 3436.29 | 3386.89 | 65191710.0 | hs300 | 3333.1653 | 3311.370050 | 1 | -0.000646 |
|---|
| 2010-04-07 | 3403.088 | 3386.949 | 3404.58 | 3369.02 | 54011228.0 | hs300 | 3344.3029 | 3308.418567 | 1 | -0.005358 |
|---|
| 2010-04-08 | 3381.306 | 3346.744 | 3381.31 | 3336.16 | 62185322.0 | hs300 | 3351.3104 | 3305.168850 | 1 | -0.011942 |
|---|
| 2010-04-09 | 3348.773 | 3379.170 | 3379.40 | 3342.47 | 51280567.0 | hs300 | 3366.3146 | 3303.630750 | 1 | 0.009642 |
|---|
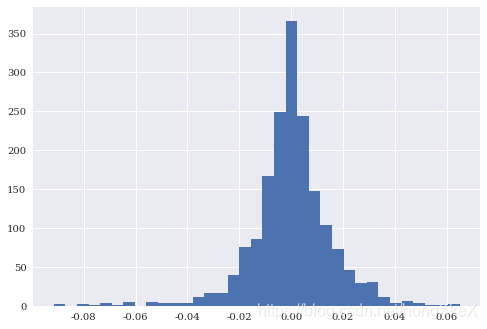
data['returns'].hist(bins=35);
data['strategy'] = data['position'].shift(1) * data['returns']
data.head()
| open | price | high | low | volume | code | SMA_10 | SMA_60 | position | returns | strategy |
|---|
| date | | | | | | | | | | | |
|---|
| 2010-04-02 | 3400.139 | 3407.346 | 3412.20 | 3391.81 | 69073452.0 | hs300 | 3322.9136 | 3313.538117 | 1 | NaN | NaN |
|---|
| 2010-04-06 | 3422.849 | 3405.145 | 3436.29 | 3386.89 | 65191710.0 | hs300 | 3333.1653 | 3311.370050 | 1 | -0.000646 | -0.000646 |
|---|
| 2010-04-07 | 3403.088 | 3386.949 | 3404.58 | 3369.02 | 54011228.0 | hs300 | 3344.3029 | 3308.418567 | 1 | -0.005358 | -0.005358 |
|---|
| 2010-04-08 | 3381.306 | 3346.744 | 3381.31 | 3336.16 | 62185322.0 | hs300 | 3351.3104 | 3305.168850 | 1 | -0.011942 | -0.011942 |
|---|
| 2010-04-09 | 3348.773 | 3379.170 | 3379.40 | 3342.47 | 51280567.0 | hs300 | 3366.3146 | 3303.630750 | 1 | 0.009642 | 0.009642 |
|---|
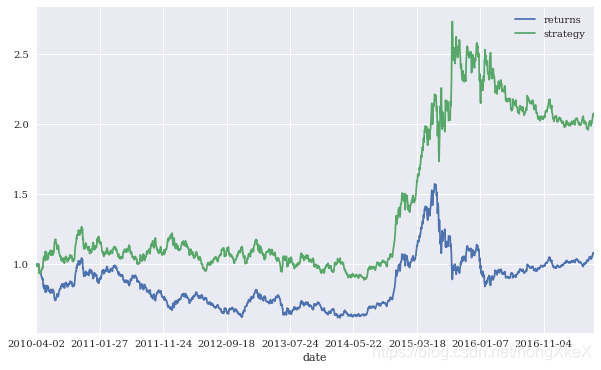
data[['returns', 'strategy']].sum()
returns     0.073386
strategy    0.727122
dtype: float64
data[['returns','strategy']].tail()
| returns | strategy |
|---|
| date | | |
|---|
| 2017-06-26 | 0.012402 | 0.012402 |
|---|
| 2017-06-27 | 0.001806 | 0.001806 |
|---|
| 2017-06-28 | -0.007800 | -0.007800 |
|---|
| 2017-06-29 | 0.006196 | 0.006196 |
|---|
| 2017-06-30 | -0.000553 | -0.000553 |
|---|
data[['returns', 'strategy']].head()
| returns | strategy |
|---|
| date | | |
|---|
| 2010-04-02 | NaN | NaN |
|---|
| 2010-04-06 | -0.000646 | -0.000646 |
|---|
| 2010-04-07 | -0.005358 | -0.005358 |
|---|
| 2010-04-08 | -0.011942 | -0.011942 |
|---|
| 2010-04-09 | 0.009642 | 0.009642 |
|---|
data[['returns', 'strategy']].cumsum().tail()
| returns | strategy |
|---|
| date | | |
|---|
| 2017-06-26 | 0.073737 | 0.727474 |
|---|
| 2017-06-27 | 0.075543 | 0.729280 |
|---|
| 2017-06-28 | 0.067744 | 0.721480 |
|---|
| 2017-06-29 | 0.073939 | 0.727676 |
|---|
| 2017-06-30 | 0.073386 | 0.727122 |
|---|
data[['returns', 'strategy']].sum()
returns     0.073386
strategy    0.727122
dtype: float64
data[['returns', 'strategy']].cumsum().apply(np.exp).tail()
| returns | strategy |
|---|
| date | | |
|---|
| 2017-06-26 | 1.076524 | 2.069846 |
|---|
| 2017-06-27 | 1.078470 | 2.073587 |
|---|
| 2017-06-28 | 1.070091 | 2.057477 |
|---|
| 2017-06-29 | 1.076741 | 2.070263 |
|---|
| 2017-06-30 | 1.076145 | 2.069118 |
|---|
data[['returns', 'strategy']].cumsum().apply(np.exp).plot(figsize=(10, 6));
4. 策略收益风险评估
data[['returns', 'strategy']].mean() * 252
returns     0.010513
strategy    0.104170
dtype: float64
data[['returns', 'strategy']].std() * 252 ** 0.5
returns     0.245468
strategy    0.245382
dtype: float64
data['cumret'] = data['strategy'].cumsum().apply(np.exp)
data['cumret'].tail()
date
2017-06-26    2.069846
2017-06-27    2.073587
2017-06-28    2.057477
2017-06-29    2.070263
2017-06-30    2.069118
Name: cumret, dtype: float64
data['cummax'] = data['cumret'].cummax()
data['cummax'].head(6)
date
2010-04-02         NaN
2010-04-06    0.999354
2010-04-07    0.999354
2010-04-08    0.999354
2010-04-09    0.999354
2010-04-12    0.999354
Name: cummax, dtype: float64
data.tail()
| open | price | high | low | volume | code | SMA_10 | SMA_60 | position | returns | strategy | cumret | cummax |
|---|
| date | | | | | | | | | | | | | |
|---|
| 2017-06-26 | 3627.02 | 3668.09 | 3671.94 | 3627.02 | 134637995.0 | hs300 | 3573.455 | 3475.314500 | 1 | 0.012402 | 0.012402 | 2.069846 | 2.731778 |
|---|
| 2017-06-27 | 3665.58 | 3674.72 | 3676.53 | 3648.76 | 97558702.0 | hs300 | 3582.700 | 3478.729667 | 1 | 0.001806 | 0.001806 | 2.073587 | 2.731778 |
|---|
| 2017-06-28 | 3664.16 | 3646.17 | 3672.19 | 3644.03 | 97920858.0 | hs300 | 3593.787 | 3481.746000 | 1 | -0.007800 | -0.007800 | 2.057477 | 2.731778 |
|---|
| 2017-06-29 | 3649.25 | 3668.83 | 3669.13 | 3644.73 | 85589498.0 | hs300 | 3607.791 | 3485.613833 | 1 | 0.006196 | 0.006196 | 2.070263 | 2.731778 |
|---|
| 2017-06-30 | 3654.73 | 3666.80 | 3669.76 | 3646.23 | 81510028.0 | hs300 | 3622.595 | 3489.126333 | 1 | -0.000553 | -0.000553 | 2.069118 | 2.731778 |
|---|
data[['cumret', 'cummax']].plot(figsize=(10, 6));
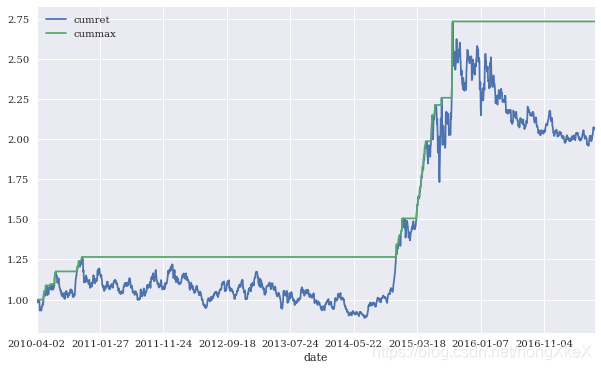
drawdown = (data['cummax'] - data['cumret'])
drawdown.max()
0.7744165301748813
temp = drawdown[drawdown == 0]
temp.head()
date
2010-04-06    0.0
2010-05-06    0.0
2010-05-07    0.0
2010-05-11    0.0
2010-05-17    0.0
dtype: float64
temp.index[1:]
Index(['2010-05-06', '2010-05-07', '2010-05-11', '2010-05-17', '2010-06-07',
       '2010-06-29', '2010-06-30', '2010-07-01', '2010-07-05', '2010-10-15',
       '2010-10-19', '2010-10-20', '2010-10-25', '2010-11-05', '2010-11-08',
       '2014-12-04', '2014-12-05', '2014-12-08', '2014-12-16', '2014-12-17',
       '2014-12-19', '2014-12-22', '2014-12-26', '2014-12-29', '2014-12-30',
       '2014-12-31', '2015-01-05', '2015-01-07', '2015-03-16', '2015-03-17',
       '2015-03-18', '2015-03-20', '2015-03-23', '2015-03-24', '2015-03-30',
       '2015-04-01', '2015-04-02', '2015-04-03', '2015-04-07', '2015-04-08',
       '2015-04-10', '2015-04-13', '2015-04-14', '2015-04-16', '2015-04-17',
       '2015-04-21', '2015-04-22', '2015-04-23', '2015-04-27', '2015-05-21',
       '2015-05-22', '2015-05-25', '2015-05-26', '2015-06-05', '2015-06-08',
       '2015-07-08', '2015-08-21', '2015-08-24', '2015-08-25', '2015-08-26'],
      dtype='object', name='date')
temp.index[:-1]
Index(['2010-04-06', '2010-05-06', '2010-05-07', '2010-05-11', '2010-05-17',
       '2010-06-07', '2010-06-29', '2010-06-30', '2010-07-01', '2010-07-05',
       '2010-10-15', '2010-10-19', '2010-10-20', '2010-10-25', '2010-11-05',
       '2010-11-08', '2014-12-04', '2014-12-05', '2014-12-08', '2014-12-16',
       '2014-12-17', '2014-12-19', '2014-12-22', '2014-12-26', '2014-12-29',
       '2014-12-30', '2014-12-31', '2015-01-05', '2015-01-07', '2015-03-16',
       '2015-03-17', '2015-03-18', '2015-03-20', '2015-03-23', '2015-03-24',
       '2015-03-30', '2015-04-01', '2015-04-02', '2015-04-03', '2015-04-07',
       '2015-04-08', '2015-04-10', '2015-04-13', '2015-04-14', '2015-04-16',
       '2015-04-17', '2015-04-21', '2015-04-22', '2015-04-23', '2015-04-27',
       '2015-05-21', '2015-05-22', '2015-05-25', '2015-05-26', '2015-06-05',
       '2015-06-08', '2015-07-08', '2015-08-21', '2015-08-24', '2015-08-25'],
      dtype='object', name='date')
temp.index[1:].to_datetime() - temp.index[:-1].to_datetime()
TimedeltaIndex([  '30 days',    '1 days',    '4 days',    '6 days',
                  '21 days',   '22 days',    '1 days',    '1 days',
                   '4 days',  '102 days',    '4 days',    '1 days',
                   '5 days',   '11 days',    '3 days', '1487 days',
                   '1 days',    '3 days',    '8 days',    '1 days',
                   '2 days',    '3 days',    '4 days',    '3 days',
                   '1 days',    '1 days',    '5 days',    '2 days',
                  '68 days',    '1 days',    '1 days',    '2 days',
                   '3 days',    '1 days',    '6 days',    '2 days',
                   '1 days',    '1 days',    '4 days',    '1 days',
                   '2 days',    '3 days',    '1 days',    '2 days',
                   '1 days',    '4 days',    '1 days',    '1 days',
                   '4 days',   '24 days',    '1 days',    '3 days',
                   '1 days',   '10 days',    '3 days',   '30 days',
                  '44 days',    '3 days',    '1 days',    '1 days'],
               dtype='timedelta64[ns]', freq=None)
periods = temp.index[1:].to_datetime() - temp.index[:-1].to_datetime()
periods
TimedeltaIndex([  '30 days',    '1 days',    '4 days',    '6 days',
                  '21 days',   '22 days',    '1 days',    '1 days',
                   '4 days',  '102 days',    '4 days',    '1 days',
                   '5 days',   '11 days',    '3 days', '1487 days',
                   '1 days',    '3 days',    '8 days',    '1 days',
                   '2 days',    '3 days',    '4 days',    '3 days',
                   '1 days',    '1 days',    '5 days',    '2 days',
                  '68 days',    '1 days',    '1 days',    '2 days',
                   '3 days',    '1 days',    '6 days',    '2 days',
                   '1 days',    '1 days',    '4 days',    '1 days',
                   '2 days',    '3 days',    '1 days',    '2 days',
                   '1 days',    '4 days',    '1 days',    '1 days',
                   '4 days',   '24 days',    '1 days',    '3 days',
                   '1 days',   '10 days',    '3 days',   '30 days',
                  '44 days',    '3 days',    '1 days',    '1 days'],
               dtype='timedelta64[ns]', freq=None)
periods.max()
Timedelta('1487 days 00:00:00')
5. 策略优化的一种思路
hs300 = ts.get_k_data('hs300','2010-01-01', '2017-06-30')[['date','close']]
hs300 = pd.DataFrame(hs300)
hs300.rename(columns={'close': 'price'}, inplace=True)
hs300.set_index('date',inplace = True)
hs300.head()
| price |
|---|
| date | |
|---|
| 2010-01-04 | 3535.229 |
|---|
| 2010-01-05 | 3564.038 |
|---|
| 2010-01-06 | 3541.727 |
|---|
| 2010-01-07 | 3471.456 |
|---|
| 2010-01-08 | 3480.130 |
|---|
hs300['SMA_10'] = hs300['price'].rolling(10).mean()
hs300['SMA_60'] = hs300['price'].rolling(60).mean()
hs300[['price', 'SMA_10', 'SMA_60']].tail()
| price | SMA_10 | SMA_60 |
|---|
| date | | | |
|---|
| 2017-06-26 | 3668.09 | 3573.455 | 3475.314500 |
|---|
| 2017-06-27 | 3674.72 | 3582.700 | 3478.729667 |
|---|
| 2017-06-28 | 3646.17 | 3593.787 | 3481.746000 |
|---|
| 2017-06-29 | 3668.83 | 3607.791 | 3485.613833 |
|---|
| 2017-06-30 | 3666.80 | 3622.595 | 3489.126333 |
|---|
hs300[['price', 'SMA_10', 'SMA_60']].plot(grid=True, figsize = (8,6));
hs300['10-60'] = hs300['SMA_10'] - hs300['SMA_60']
hs300['10-60'].tail()
date
2017-06-26     98.140500
2017-06-27    103.970333
2017-06-28    112.041000
2017-06-29    122.177167
2017-06-30    133.468667
Name: 10-60, dtype: float64
SD = 20
hs300['regime'] = np.where(hs300['10-60'] > SD, 1,0)
hs300['regime'] = np.where(hs300['10-60'] < -SD, -1,hs300['regime'])
hs300['regime'].value_counts()
 1    792
-1    751
 0    276
Name: regime, dtype: int64
hs300.tail(20)
| price | SMA_10 | SMA_60 | 10-60 | regime |
|---|
| date | | | | | |
|---|
| 2017-06-05 | 3468.75 | 3457.542 | 3448.415500 | 9.126500 | 0 |
|---|
| 2017-06-06 | 3492.88 | 3466.445 | 3449.064167 | 17.380833 | 0 |
|---|
| 2017-06-07 | 3533.87 | 3478.708 | 3450.483167 | 28.224833 | 1 |
|---|
| 2017-06-08 | 3560.98 | 3492.387 | 3452.717167 | 39.669833 | 1 |
|---|
| 2017-06-09 | 3576.17 | 3507.587 | 3455.188500 | 52.398500 | 1 |
|---|
| 2017-06-12 | 3574.39 | 3516.460 | 3457.126667 | 59.333333 | 1 |
|---|
| 2017-06-13 | 3582.27 | 3526.644 | 3459.219667 | 67.424333 | 1 |
|---|
| 2017-06-14 | 3535.30 | 3530.886 | 3460.414000 | 70.472000 | 1 |
|---|
| 2017-06-15 | 3528.79 | 3533.991 | 3461.202000 | 72.789000 | 1 |
|---|
| 2017-06-16 | 3518.76 | 3537.216 | 3462.417833 | 74.798167 | 1 |
|---|
| 2017-06-19 | 3553.67 | 3545.708 | 3464.152167 | 81.555833 | 1 |
|---|
| 2017-06-20 | 3546.49 | 3551.069 | 3465.487833 | 85.581167 | 1 |
|---|
| 2017-06-21 | 3587.96 | 3556.478 | 3467.786333 | 88.691667 | 1 |
|---|
| 2017-06-22 | 3590.34 | 3559.414 | 3469.925667 | 89.488333 | 1 |
|---|
| 2017-06-23 | 3622.88 | 3564.085 | 3472.147000 | 91.938000 | 1 |
|---|
| 2017-06-26 | 3668.09 | 3573.455 | 3475.314500 | 98.140500 | 1 |
|---|
| 2017-06-27 | 3674.72 | 3582.700 | 3478.729667 | 103.970333 | 1 |
|---|
| 2017-06-28 | 3646.17 | 3593.787 | 3481.746000 | 112.041000 | 1 |
|---|
| 2017-06-29 | 3668.83 | 3607.791 | 3485.613833 | 122.177167 | 1 |
|---|
| 2017-06-30 | 3666.80 | 3622.595 | 3489.126333 | 133.468667 | 1 |
|---|
hs300['Market'] = np.log(hs300['price']/hs300['price'].shift(1))
hs300['Strategy'] = hs300['regime'].shift(1) * hs300['Market']
hs300[['Market','Strategy']].cumsum().apply(np.exp).plot(grid=True, figsize = (8,6));
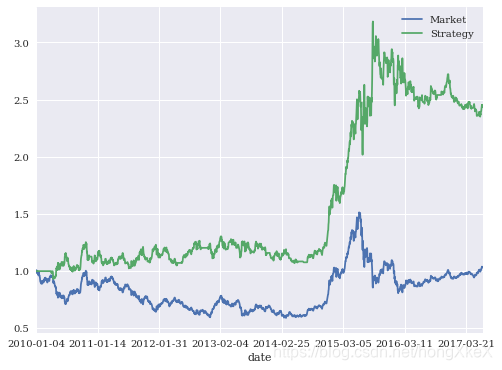
hs300.head()
| price | SMA_10 | SMA_60 | 10-60 | regime | Market | Strategy |
|---|
| date | | | | | | | |
|---|
| 2010-01-04 | 3535.229 | NaN | NaN | NaN | 0 | NaN | NaN |
|---|
| 2010-01-05 | 3564.038 | NaN | NaN | NaN | 0 | 0.008116 | 0.0 |
|---|
| 2010-01-06 | 3541.727 | NaN | NaN | NaN | 0 | -0.006280 | -0.0 |
|---|
| 2010-01-07 | 3471.456 | NaN | NaN | NaN | 0 | -0.020040 | -0.0 |
|---|
| 2010-01-08 | 3480.130 | NaN | NaN | NaN | 0 | 0.002496 | 0.0 |
|---|
hs300[['Market', 'Strategy']].sum()
Market      0.036541
Strategy    0.896131
dtype: float64
hs300[['Market', 'Strategy']].mean() * 252
Market      0.005065
Strategy    0.124216
dtype: float64
hs300[['Market', 'Strategy']].std() * 252 ** 0.5
Market      0.244318
Strategy    0.235367
dtype: float64
 8
 0


 已为社区贡献1条内容

所有评论(0)